查找的基本概念
- 查找表
由同一类型的数据元素(或记录)构成的集合
- 两类查找表
- 静态查找表: 只进行查找,不需要插入或删除记录。
- 动态查找表: 除查找外,还支持插入和删除记录,并维护相应的查找结构。
- 基本术语
关键字: 记录中某个数据项的值,可用来识别一个记录
两类关键字: 主关键字和次关键字
主关键字: 唯一标识数据元素
次关键字: 可以表示若干个数据元素
- 查找算法的评价指标
查找过程中关键字的平均比较次数,称为平均查找长度 ASL(Average Search Length)。分析时需要区分查找成功和查找失败,并说明各记录被查找的概率。
- 查找的方法
顺序查找、二分查找、分块查找、二叉排序树查找、平衡二叉树查找、B-树、B+树、散列查找
方法1️⃣ 顺序查找
应用范围:
顺序表或线性链表表示的查找表,对表内元素是否有序没有要求。
- 顺序表的表示
typedef int KeyType;

typedef struct {
  KeyType key; // 记录的关键字
} ElemType;

typedef struct {
  ElemType *R; // R[0] 为哨兵,R[1] 到 R[length] 为实际记录
  int length; // 实际记录数,不包含哨兵
} SSTable;- 在顺序表 ST 中查找关键字为 key 的记录
把待查关键字 key 存入预留的表头位置 R[0](“哨兵”),从后向前逐个比较,可免去每次比较时检查下标是否越界。R 数组需要分配 length+1 个元素;返回 0 表示查找失败,否则返回实际记录的位置。
int Search_Seq(SSTable ST, KeyType key) {
  int i;
  ST.R[0].key = key;
  for (i = ST.length; ST.R[i].key != key; --i) {
    // 哨兵保证循环最迟在 i=0 时结束
  }
  return i;
}- 顺序查找的性能分析
空间复杂度: O(1),只需一个哨兵位置和固定数量的辅助变量。
时间复杂度: 最好为 O(1),平均和最坏为 O(n)。
平均查找长度: 设表中 n 条记录被查找的概率相等,成功时的比较次数依次为 1 到 n。
ASL成功 = (1+2+…+n)/n = (n+1)/2
查找失败时需要检查全部 n 条记录。对于上述哨兵实现,若把与 R[0] 的比较也计入,则 ASL失败 = n+1。
- 顺序查找算法的特点
算法简单,可用于顺序存储和链式存储。上述代码使用顺序表;链表需要沿指针遍历,不能直接按下标访问。
当n很大时查找效率较低
改进措施: 在满足相应的有序条件时,可采用二分查找或分块查找。
方法2️⃣:二分查找
折半查找的前提条件是: 查找表按关键字有序排列,并支持随机访问。下面以按升序排列的顺序表为例。
- 思想
折半查找(Binary Search)将待查关键字 key 与当前查找区间的中间元素比较。若相等,则查找成功;若 key 较小,则继续查找左半区;若 key 较大,则继续查找右半区。重复此过程,直到找到目标或查找区间为空。
- 举例过程
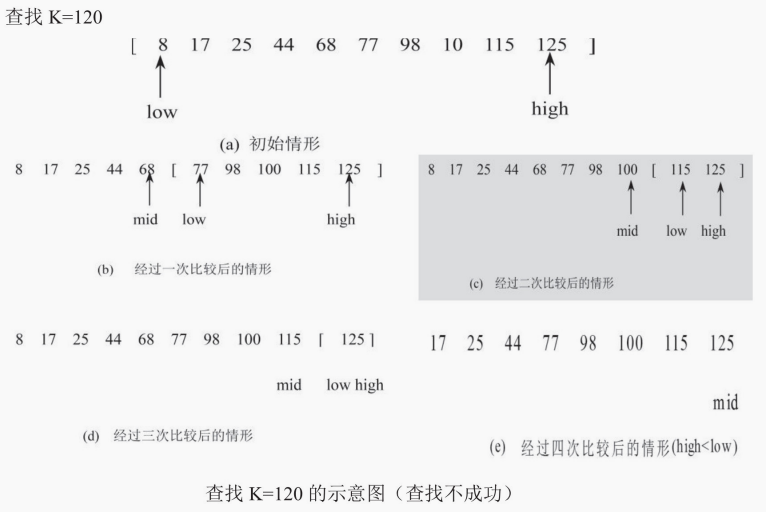
图中查找 K=120,依次与 68、100、115、125 比较,最终 high < low,查找失败。完整序列应为 8、17、25、44、68、77、98、100、115、125;原图初始行的“10”应为“100”,末幅有漏项,应以此完整序列为准。
- 性能分析
可以用二叉树描述二分查找过程:将当前区间的中间元素作为根结点,左、右子区间分别按相同方式构造子树,得到二分查找的判定树。
每次比较后,待查区间最多缩小到原来的一半。最好时间复杂度为 O(1),最坏为 O(log₂ n)。非递归实现的额外空间复杂度为 O(1),递归实现最坏需要 O(log₂ n) 的调用栈空间。
- 算法描述
折半查找(非递归算法)
function Search_Bin(ST, key) {
  // 找到时返回从 0 开始的数组下标,否则返回 -1
  let low = 0;
  let high = ST.length - 1;
  while (low <= high) {
    // 用差值计算中点,也便于迁移到使用固定宽度整数的语言
    const mid = low + Math.floor((high - low) / 2);
    if (key === ST[mid]) {
      return mid;
    } else if (key < ST[mid]) {
      high = mid - 1;
    } else {
      low = mid + 1;
    }
  }
  return -1;
}
console.log(Search_Bin([1,2,3,4,5,6,7,8,9], 3)); // 2
const example = [8,17,25,44,68,77,98,100,115,125];
console.log(Search_Bin(example, 120)); // -1,与上图一致
折半查找(递归算法)
function Search_Bin(ST, key, low, high) {
  if (low > high) {
    return -1; // 查找不到时返回 -1
  }
  const mid = low + Math.floor((high - low) / 2);
  if (key === ST[mid]) {
    return mid;
  } else if (key < ST[mid]) {
    return Search_Bin(ST, key, low, mid - 1);
  } else {
    return Search_Bin(ST, key, mid + 1, high);
  }
}
const L = [1,2,3,4,5,6,7,8,9];
console.log(Search_Bin(L, 3, 0, L.length - 1)); // 2
方法3️⃣:分块查找
将查找表分成若干块,要求前一块中的所有关键字都小于后一块中的关键字,但块内不要求有序,即“块间有序,块内可以无序”。
各块的最大关键字构成有序的索引表,索引项还需要记录对应块的起始位置和范围。
👉分块查找过程
- 对索引表使用折半查找,找到第一个最大关键字不小于 key 的块;若不存在这样的块,则查找失败。这里查找的是候选块,不要求 key 等于索引中的最大关键字。
- 在候选块内采用顺序查找,找到 key 则成功,否则失败。
分块查找性能分析
时间复杂度: 设有 b 个块,每块最多 s 条记录。对索引表使用折半查找,再在块内顺序查找,最坏时间复杂度为 O(log₂ b+s);若对索引表也使用顺序查找,则为 O(b+s)。
适用条件: 记录能够按关键字范围分块,并维护有序索引。索引表若采用折半查找,需要支持随机访问;块内则可以顺序遍历,不要求全部记录有序。
分块查找优缺点:
优点: 块内无需保持有序,插入和删除时通常可以减少记录移动。
缺点: 需要额外的索引空间。插入和删除后仍需维护块间有序、块的范围和索引信息,必要时调整分块。
适用情况: 如果线性表既要快速查找又经常动态变化,则可采用分块查找。
方法4️⃣:树表的查找
树形查找表可以在插入和删除记录时动态维护。单纯查找时,找到 key 则成功,否则返回失败;若执行的是“查找并插入”操作,则可以在查找失败的位置插入新记录。
方法1:二叉排序树查找
二叉排序树查找: 前提是将查找表组织成为一棵二叉排序树。
思想:
若二叉排序树为空,则查找失败。否则,将 key 与根结点的关键字比较:相等时成功;key 较小时继续查找左子树;key 较大时继续查找右子树。重复此过程,直到找到目标或进入空子树。
二叉排序树特点:
二叉排序树是空树,或是满足如下性质的二叉树:
- 若其左子树非空,则左子树上所有结点的值均小于根结点的值
- 若其右子树非空,则右子树上所有结点的值均大于根结点的值
- 其左右子树本身又各是一棵二叉排序树
生成二叉排序树的过程:
例如,给定关键字序列: 79,62,68,90,88,89,17,5,100,120
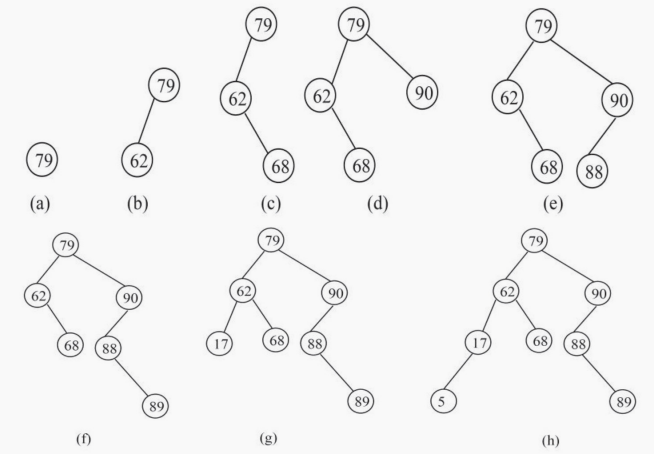
图片演示了前 8 个关键字的插入过程,最后停在插入 5 的状态。继续插入时,100 成为 90 的右孩子,120 成为 100 的右孩子,这两步未画在图中。
算法思想:
若二叉排序树为空,则查找失败,返回空指针
若二叉排序树非空,将 key 与根结点的关键字
T->data.key比较。
- 若 key 等于
T->data.key,则查找成功,返回根结点地址。- 若 key 小于
T->data.key,则继续查找左子树。- 若 key 大于
T->data.key,则继续查找右子树。
- 二叉排序树的性能分析
设树高为 h,查找时间复杂度为 O(h)。树形平衡时,h 为 O(log₂ n);退化为单链时,h 为 O(n)。单次查找若直接命中根结点,最好时间复杂度为 O(1)。二叉排序树与有序顺序表上的二分查找各有适用场景,不能简单认定前者一定更慢。
- 存在问题: 插入顺序不合适时可能退化为单链结构,使最坏查找时间达到 O(n)。
方法2:平衡二叉树
这里讨论 AVL 树,即通过旋转等操作维护平衡的二叉排序树。
- 思想
AVL 树的查找方式与二叉排序树相同:比较当前结点与 key,按大小进入左子树或右子树,直到找到目标或进入空子树。平衡维护发生在插入、删除时,单纯查找不需要旋转。
- 举例过程
第一步:插入记录时维护二叉排序树的平衡。 第二步:按照二叉排序树的方法查找。
平衡二叉树定义:
若一棵二叉排序树中,每个结点的左、右子树高度之差的绝对值不超过 1,则称为 AVL 树。
平衡因子:
左子树高度减去右子树高度,得到该结点的平衡因子(balance factor)。
说明:
一棵二叉排序树中,所有结点的平衡因子只能为0,1,-1时,则该二叉排序树就是一棵平衡二叉树。
第一步: 非平衡二叉树的平衡处理
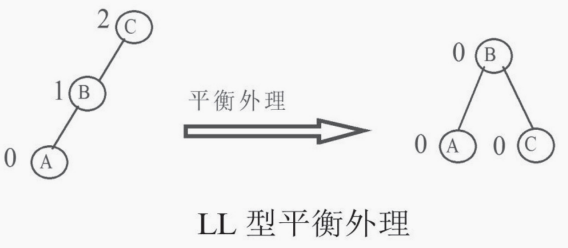
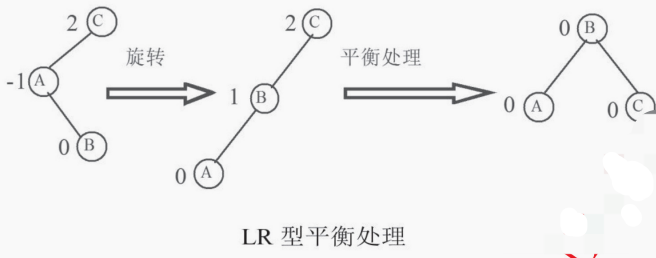
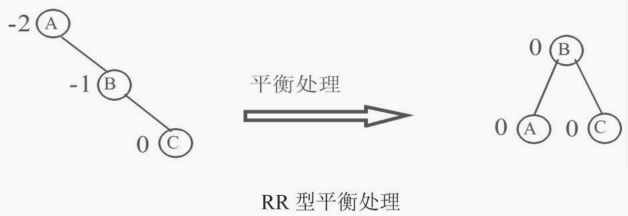
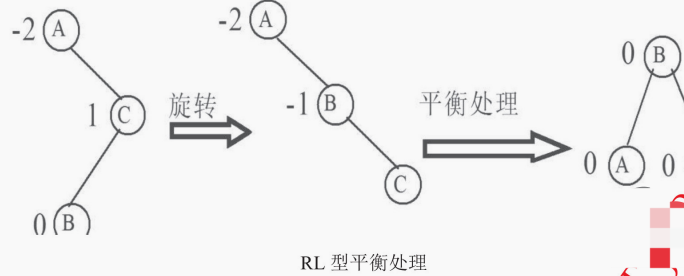
插入某个结点后,原本平衡的二叉排序树可能失衡。沿插入路径向上,找到离插入点最近、平衡因子绝对值大于 1 的祖先结点,对其进行旋转调整。下面分四种情况说明。
情况1: LL 型(左左型),对失衡结点进行一次右旋。
情况2: LR 型(左右型),先对失衡结点的左孩子左旋,再对失衡结点右旋。
情况3: RR 型(右右型),对失衡结点进行一次左旋。
情况4: RL 型(右左型),先对失衡结点的右孩子右旋,再对失衡结点左旋。
- 平衡二叉树的查找及性能分析
AVL 树将树高保持在 O(log₂ n),因此最坏查找时间复杂度为 O(log₂ n),不会像普通二叉排序树那样退化为 O(n)。单次查找直接命中根结点时,最好时间复杂度仍为 O(1)。
方法3: B-树
- 定义:B-树是一种平衡的多路查找树
本文将 B-树简称为 B 树,m 阶表示一个结点最多有 m 棵子树。一棵 m 阶 B 树或为空树,或满足下列性质:
- 每个结点最多有 m-1 个关键字;非叶子结点最多有 m 棵子树。
- 若根结点不是叶子结点,则至少有两棵子树。
- 除根结点外,每个非叶子结点至少有 ⌈m/2⌉ 棵子树,每个结点至少有 ⌈m/2⌉-1 个关键字。⌈m/2⌉ 表示向上取整。
- 结点中的关键字按升序排列,含 n 个关键字的非叶子结点有 n+1 棵子树,各子树的关键字落在对应的分隔范围内。
- 非叶子结点可表示为
(n, A₀, K₁, A₁, …, Kₙ, Aₙ),其中 n 为关键字个数,K 为关键字,A 为子树指针。 - 所有叶子结点位于同一层。
例如,4 阶 B 树的非叶子结点最多有 4 个子树指针,每个结点最多有 3 个关键字。
上述最少关键字数和子树数的限制需要排除根结点;非空树的根结点可以只有一个关键字,叶子结点没有子树。
B-树的删除: 兄弟够,低升高降。兄弟不够,拉下来合并
这个口诀用于删除后结点关键字不足的情况:若相邻兄弟有富余关键字,则借助父结点进行调整;若兄弟也没有富余关键字,则将父结点中的分隔关键字下移,与兄弟结点合并。父结点若因此不足,还需继续向上调整。
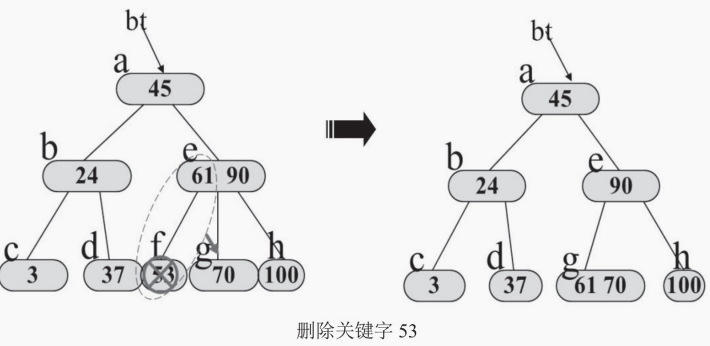
图中删除关键字 53 后,该叶子结点变空,右兄弟只有关键字 70,无法借出。因此将父结点中的 61 下移,与右兄弟合并成包含 61、70 的结点,父结点保留 90。
方法4: B+ 树
- B+ 树是 B 树的一种变形,两者的主要区别如下。
本文采用的约定: 非叶子结点的每个索引项对应一棵子树,索引关键字取该子树的最大关键字。因此非叶子结点的关键字数与子树数相同,m 阶结点最多有 m 个索引项;叶子结点最多存放 m 个关键字。不同教材和实现也可能采用分隔关键字的定义,需要区分其结点容量和更新规则。
叶子层包含全部关键字及对应记录的指针,各叶子结点按关键字从小到大的顺序链接,便于顺序访问和范围查找。
非叶子结点只保存索引关键字和子树指针,实际记录信息位于叶子层。
操作: B+树的查找、插入、删除
在 B+ 树上按给定关键字查找、插入和删除的过程与 B 树类似,但最终都需要定位到叶子结点。
查找: 按本文的约定,每层选择第一个最大关键字不小于 key 的子树。即使 key 等于非叶子结点中的索引关键字,也需要继续向下,在叶子结点中确认记录是否存在。若没有候选子树,或叶子中不存在 key,则查找失败。
B+ 树的高度和查找性能分析与 B 树类似。在阶数固定时,最坏查找时间为 O(log₂ n),较大的分支数可以减少访问的层数。
插入: 记录插入到叶子结点。按本文约定,关键字个数超过 m 时,需要分裂为两个结点,分别保留 ⌊(m+1)/2⌋ 和 ⌈(m+1)/2⌉ 个关键字,并在父结点中维护这两个结点的最大关键字和指针。父结点若也超过容量,则继续向上分裂;若子树最大关键字变化,也需要更新上层索引。
删除: 记录从叶子结点删除。按本文采用的最大关键字索引约定,若子树最大关键字变化,需要同步更新上层索引。非根结点的关键字个数若少于 ⌈m/2⌉,则先尝试向兄弟结点借用,否则合并,并继续维护父结点;必要时树高会降低。
方法5️⃣:散列查找
优点: 通过散列函数计算候选存储位置,通常可以减少关键字比较;发生冲突时仍需按相应规则继续查找。
- Hash方法:通过函数计算存储位置
- Hash函数:在Hash方法中使用的函数
- Hash表:按Hash方法构造出来的表称为Hash表
- Hash地址:通过Hash函数计算记录的存储位置,称Hash地址
- 冲突(Collision):不同关键字经 Hash 函数计算,可能得到相同地址,即
key1 != key2,但H(key1) = H(key2)。
知识点1. 如何构造Hash函数?
要求: 对于给定的一个关键码集合,选择一个计算简单且地址分布比较均匀的Hash函数,避免或尽量减少冲突。
知识点2. 拟定解决冲突的方案
要求: 允许冲突,但要有解决的方法
知识点3. Hash 查找的性能
知识点1:Hash函数的构造
构造 Hash 函数应注意以下几个问题:
- 计算Hash函数所需时间
- 关键字的长度
- Hash表的大小
- 关键字的分布情况
- 记录的查找频率
- 直接定址法
取关键字的某个线性函数值作为散列地址。
Hash地址:H(key) = a*key + b
其中: a、b 为固定整数,需要保证计算出的地址在表的有效范围内。
对于整数关键字,a 不为 0 且地址范围足够时,不同关键字可映射到不同地址。这种方法适合关键字范围较小、分布较连续的情况;关键字范围很大而记录较少时,会浪费存储空间。
- 除留余数法
设表长为 m,对非负整数关键字,可以选择不大于 m 的正整数 p,常见做法是选择接近 m 的质数,再用余数作为地址:
H(key) = key % p,其中 0 < p <= m。p 的选择应结合关键字分布,避免大量关键字得到相同余数。
- 数字分析法
设有n个d位数,每一位可能有r种不同的符号。这r种不同的符号在各位上出现频率不一定相同。可根据Hash表的大小,选取其中各种符号分布均匀的若干位作为Hash地址。
- 平方取中法
先将关键字平方,再根据表的大小取结果中间的若干位作为散列地址。例如,取 r 个二进制位,可以得到 0 到 2ʳ-1 范围内的地址;地址本身不要求是 2 的幂。
- 折叠法————有两种方法:
第一种: 移位法把各部分的最后一位对齐相加。
第二种: 分界折叠法沿各部分的分界来回折叠,相当于将相邻部分的数字顺序交替反转,再对齐相加。相加结果还需按表的大小截取或取余,得到有效地址。
- 随机数法
随机数法使用以关键字为输入的伪随机映射,将结果映射到表的有效地址范围。
即 H(key) = random(key)。
这里的 random 表示参数固定的伪随机映射:同一关键字在同一张表中必须得到相同地址。不能在每次查找时调用随机数生成器产生新的地址。
知识点2:拟定解决冲突的方案
原因: 理想情况下,不同关键字映射到不同地址;实际中,多个关键字可能得到同一地址,称为冲突(collision),这些关键字互称为“同义词”。发生冲突时不能直接覆盖已有记录,需要采用探测、链表等处理方法。是否冲突取决于散列函数与关键字集合,不能仅根据函数是否为线性函数来判断。
冲突通常难以完全避免,散列查找的性能主要与以下三个方面有关。
第一是装填因子 α,即元素个数 n 与表长或桶数 m 的比值:α = n/m。开放地址法通常需要保持 α<1;链地址法允许一个桶存放多个记录,因此 α 可以大于 1。较小的 α 通常有利于减少探测或链表遍历,但也会增加空闲空间,需要兼顾时间和空间。
第二是与所构造的散列函数有关。
第三是与解决冲突的方法有关。
装填因子的选择取决于冲突处理方式和实现,没有通用的“0.6~0.9 最佳”范围。
解决冲突的方法
- 开放地址法
开放地址法将记录存放在散列表内部。先检查初始散列地址,发生冲突时按探测序列检查其他位置。
插入时寻找可用位置;查找时找到目标则成功,遇到从未使用过的空位置则失败。探测次数应有上限,避免表已满或探测序列重复时无限循环。删除记录时需要使用删除标记等方法,不能直接把探测链中间的位置改成从未使用过的空位置。
下述公式来描述:
Hᵢ(key) = (H(key) + dᵢ) % m,其中 i 从 0 开始,d₀=0。
其中: Hᵢ(key) 为第 i 个候选地址,H(key) 为初始散列地址,m 为表长,dᵢ 为相对初始地址的偏移量。某些探测方式容易产生“聚集(clustering)”现象,使连续冲突增加查找开销。
一般情况下,地址增量的取值有以下三种:
dᵢ = i,即 0、1、2、…、m-1。
称这种情况为线性探测再Hash;
偏移量依次取 0、1²、-1²、2²、-2²、…、K²、-K²,其中 K≤⌊m/2⌋。计算时需要将地址规范到 0 至 m-1;在 JavaScript 中可使用 ((H(key) + dᵢ) % m + m) % m。
这种情况为二次探测再Hash:
偏移量也可以由固定参数的伪随机序列产生,称为伪随机探测再 Hash。同一关键字的插入和查找必须使用相同的探测序列。
二次探测不一定覆盖所有位置,即使表中仍有空槽,也可能找不到可用位置;需要配合合适的表长、装填因子和扩容策略。
- 链地址法
链地址法将散列地址相同的记录链接在同一个桶的链表中,各桶的表头组成一个数组。该数组的长度等于桶数 m,与关键字个数 n 不必相同。
- 建立公共溢出区
建立公共溢出区是指当冲突发生时,将这些关键字存储在另设立的一个公共溢出区中。具体的做法是:假设Hash地址区间为0到(m-1),设向量HashTable[m]为基本表,每一个分量存放一个记录,另外设一个向量OverTable[n]为溢出表。将所有与基本表中关键字冲突的记录,都存放到该溢出表中。
- 再Hash法
再 Hash 法在冲突发生时,使用其他散列函数计算候选地址,例如 H₁(key)、H₂(key)、…、Hₖ(key)。插入和查找需要按相同顺序使用这些函数。这种方法可以减轻聚集,但会增加计算开销,也需要处理候选位置均不可用的情况。
知识点3:Hash查找性能分析(散列查找性能分析)
在散列函数分布较均匀、装填因子得到控制,且关键字散列和比较的开销视为常数时,散列查找的平均时间通常为 O(1)。大量冲突时,最坏时间可能达到 O(n)。平均查找长度取决于冲突处理方式、装填因子,以及查找是否成功,不能统一认定为 1。
- 线性探查法的性能分析
在初始散列地址独立、均匀分布,且成功查找时各记录等概率的分析假设下,当表较大且 α<1 时,线性探测的平均探测次数近似为:
- 成功查找:
ASL成功 ≈ 1/2 × [1 + 1/(1-α)] - 失败查找:
ASL失败 ≈ 1/2 × [1 + 1/(1-α)²]
α 接近 1 时,探测开销会明显增加。公式及分析条件可参见 普林斯顿大学散列表课程资料。
- 拉链法查找的性能分析
拉链法先定位桶,再沿链表比较关键字。在散列地址独立、均匀分布且各记录被成功查找的概率相等时:
- 成功查找:
ASL成功 = 1 + (n-1)/(2m) ≈ 1 + α/2 - 失败查找:
ASL失败 = α
这里 ASL 只统计链表内的关键字比较次数,不包含计算散列地址和访问桶的固定开销。